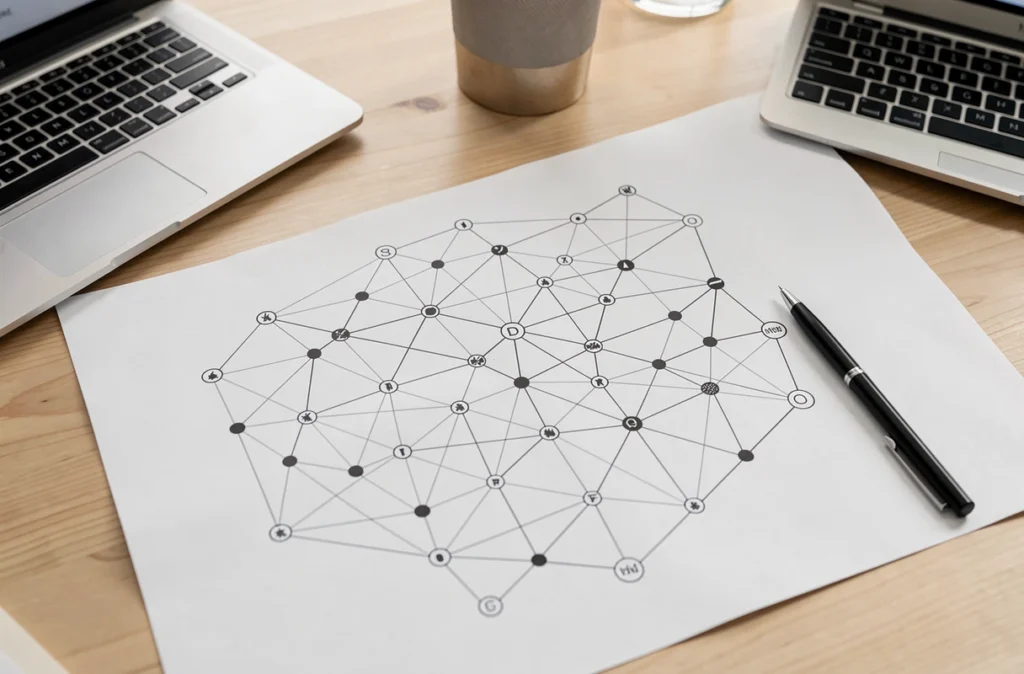
La cartographie du web consiste à collecter les liens hypertextes entre des sites, puis à les dessiner sous forme de graphe. Chaque site devient un nœud, chaque lien une arête, et la carte montre qui cite qui et quels groupes se forment.
Le résultat ressemble à un plan de métro dont les stations seraient des sites et les lignes, des liens. Il sert à comprendre la structure d’un sujet en ligne, pas à visiter une page précise.
Cartographie du web : de quoi parle-t-on ?
Une carte du web est un graphe orienté : un lien de A vers B ne signifie pas que B renvoie vers A. Cette direction compte, car elle distingue les sites qui reçoivent beaucoup de liens de ceux qui en émettent beaucoup.
Elle ne se confond pas avec la carte de l’infrastructure d’Internet, qui représente câbles, routeurs et serveurs. Ici, seul le contenu compte, c’est-à-dire les pages et les liens que leurs auteurs ont placés. Le rôle d’un portail web se lit d’ailleurs bien sur ce type de carte : un portail est typiquement un nœud très relié, vers lequel et depuis lequel circulent de nombreux liens.
D’où vient l’idée de cartographier le web
Les premiers travaux sur la structure globale du web datent de la fin des années 1990. L’étude de Broder et de ses collègues, menée sur des explorations de mai et octobre 1999 (203 et 271 millions d’URL), décrit un web en nœud papillon.
Au centre, un noyau fortement connecté : toutes ses pages peuvent s’atteindre en suivant des liens. À gauche, la zone IN regroupe les pages qui mènent au noyau sans qu’on puisse en revenir. À droite, la zone OUT rassemble les pages accessibles depuis le noyau, qui ne renvoient pas vers lui. Les excroissances et les îlots déconnectés complètent la figure.
Sur l’exploration de mai 1999, le noyau compte environ 56 millions de pages, contre environ 43 millions pour chacune des zones IN et OUT. Il est donc loin d’englober la majorité du web.
Les sciences sociales ont repris l’outil ensuite : on cartographie les sites d’une controverse, d’une communauté ou d’un territoire pour voir comment les acteurs se citent et s’ignorent.
Construire une carte du web : corpus, crawl et visualisation
Une carte se construit en quatre temps, et chacun oriente le résultat.
- Poser la question et choisir les sites de départ, appelés graines : un thème, une controverse, un secteur.
- Collecter les liens avec un robot (crawl), à partir des graines et jusqu’à une profondeur fixée, par exemple les sites cités par les graines, puis ceux qu’ils citent à leur tour.
- Trier le corpus : écarter les plateformes généralistes qui relient tout le monde et brouillent la lecture, garder les sites pertinents.
- Disposer les nœuds avec un algorithme de placement par forces : les sites liés s’attirent, les autres se repoussent, ce qui fait apparaître des groupes.
Le robot doit respecter le fichier robots.txt, que la RFC 9309 a formalisé en septembre 2022 d’après la méthode définie par Martijn Koster en 1994. Cette norme n’est pas un contrôle d’accès : elle indique aux robots ce que l’exploitant du site demande de ne pas explorer. Il faut aussi espacer les requêtes, faute de quoi le serveur répond par une erreur, comme l’explique cet article sur la limitation du nombre de requêtes.
Lire une carte : nœuds, liens et centralité
La taille d’un nœud reflète en général le nombre de liens qu’il reçoit, ou degré entrant. Un gros nœud est un site que les autres citent : c’est la mesure la plus simple de sa place dans le corpus.
La proximité de deux nœuds indique qu’ils se citent mutuellement ou citent les mêmes sites. Les groupes (clusters) correspondent à des communautés qui se lisent entre elles, par exemple des sites d’un même métier ou d’une même opinion.
Les passerelles entre deux groupes sont souvent les nœuds les plus intéressants : ce sont les rares sites qui relient des milieux qui ne se citent pas directement. À l’inverse, un nœud isolé en périphérie n’est lié à presque personne, ce qui ne dit rien de la qualité de son contenu.
À quoi sert la cartographie du web
En recherche, elle sert à décrire un débat public ou à repérer les acteurs dominants d’un sujet. En veille, elle montre l’apparition d’un nouvel acteur ou le déplacement d’un groupe de sites au fil des mois.
En référencement, la même logique s’applique à l’échelle d’un site : liens entrants et maillage interne dessinent une carte que l’on peut examiner pour trouver les pages orphelines ou celles qui concentrent les liens.
Les limites d’une carte du web
Une carte dépend d’abord de son corpus et de sa profondeur de crawl : changer les graines change la carte. Les plateformes fermées, comme les réseaux sociaux ou les pages derrière une connexion, y restent largement invisibles.
Elle fige aussi un état à une date donnée, alors que les liens apparaissent et disparaissent. Enfin, la mise en forme oriente la lecture : l’algorithme de placement, les couleurs et les échelles de taille produisent une image, pas une transcription neutre du réel.
Une exploration méthodique s’oppose ainsi à l’exploration du web au hasard : la première fixe ses règles à l’avance et les documente, la seconde se contente de rebondir de page en page.
Web mapping : l’autre sens de l’expression
L’expression désigne aussi la cartographie en ligne, c’est-à-dire la production et la publication de cartes géographiques interactives sur Internet. Le sujet change : on représente un territoire, non les liens entre sites.
Pour publier ce type de carte, l’intégration d’une carte interactive à un site suit une logique à part, décrite dans cet autre article du site.
La cartographie du web, au sens de graphe de liens, reste un exercice d’interprétation : chaque carte répond à une question posée au départ, et change de forme quand on la pose autrement.